개발 중 본 적 없는 7,379판
모두 풀어냄
 ZIGU LABS
트랜스포머와 LLM에서 벗어난 독자 AI 아키텍처
초고난도 스도쿠 정답률 100% LLM, Transformer 없이 자신의 기억을 근거로 추론하는 소버린 AI
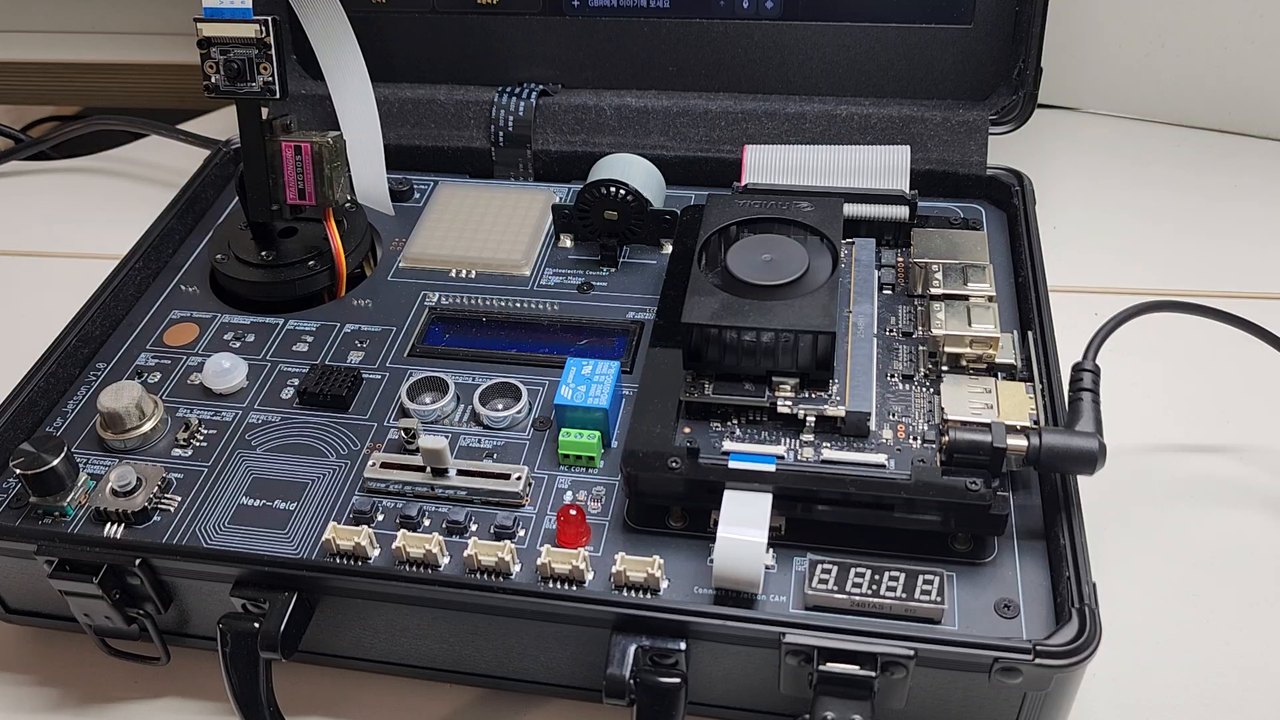
GBR은 손바닥만 한 초소형 컴퓨터에서도 동작합니다.
REASONING RESULT
초고난도 스도쿠 데이터셋 Sudoku-Extreme의 공개 시험 문제 422,786판에서, 결과를 보기 전에 정한 규칙으로 1만 판을 뽑았습니다. GBR 추론 엔진이 추측과 되돌림 없이 판마다 한 번에 모두 풀었고, 판마다 정답 확인 증명서를 누구나 돌릴 수 있는 검사기와 함께 GitHub에 공개했습니다. (증명서는 답이 그 판의 유일한 해임을 보이며, 그 답을 GBR 추론 엔진이 냈다는 실행 기록을 보유 하고 있습니다. 추론 과정의 상세 데이터는 역공학 등의 우려로 NDA등 협의를 통해 열람 가능합니다)
모두 풀어냄
모두 풀어냄
깃허브에서 확인 할 수 있습니다
ON-DEVICE DEMONSTRATION
메모리 8 GB인 NVIDIA Jetson Orin Nano Super에서, 네트워크를 차단하고 촬영했습니다. 저장된 지식으로 답하고 그 자리에서 새 지식을 배우고 거둡니다. 자연어로 카메라와 모터를 움직입니다.
실제 장치에서 확인한 실행 흐름
 유튜브에서 시연 영상 보기
네트워크 없이도 기기에 저장된 지식을 읽고 출처와 함께 답합니다.
한 문장을 가르치자 재시작이나 재학습 없이 다음 질문부터 사용합니다.
거둔 지식은 사용하지 않고, 기록은 남깁니다.
움직이기 전에 먼저 안전을 확인하고, 서보 모터와 카메라를 조작합니다.
PERSISTENT MEMORY
지식을 가중치가 아니라 출처와 버전이 붙은 기억 단위로 따로 둡니다. 더하거나 고치거나 거두면 다시 학습하지 않아도 바로 다음 답부터 반영되고, 무엇이 바뀌었는지 기록이 남습니다. 근거가 엇갈리면 되묻고, 없으면 모른다고 답합니다.
시연 영상 8:08 — 아직 배우지 않은 회사를 물었습니다.
지구랩스는 뭐야?
아직 배우지 않았습니다. 「지구랩스」로 읽었는데, 맞게 읽었나요?시연 영상의 실제 대화입니다(8:02 ~ 10:10). 화면 글자를 간추려 옮겼습니다.
영상에서 이 장면 보기 →같은 꼴이 기억 하나에서 묶음, 윗묶음까지 크기마다 되풀이됩니다. 그래서 기억이 늘어도 필요한 부분만 찾아 읽을 수 있습니다. 임베딩도 자체 개발입니다.
정해진 범위 안에서는 질문과 가장 가까운 기억을 하나도 빠뜨리지 않고 찾아내고, 범위를 벗어나면 그 사실을 알리거나 답을 미룹니다. 제로 미스(Zero-Miss) 검색입니다.
지식 전체를 메모리에 올려 두지 않고, 그 순간 필요한 기억만 저장 장치에서 흘려 읽습니다. 그래서 작은 기기에서도 큰 기억을 씁니다.
새 지식의 게시, 정정, 철회가 모두 데이터베이스 연산입니다. 기억마다 얼마나 오래 간직할지도 정할 수 있습니다.
자체 지각 엔진으로 이미지, 사운드, 센서 입력을 받아들입니다.
대상과 의도, 시간, 부정, 조건 같은 뜻을 알아듣습니다.
기억을 근거로 연역과 귀납으로 따지고, 답할지, 되물을지, 보류할지 판단합니다.
판단한 뜻을 말로 짓고, 쓴 근거를 잇습니다.
말, 글, 동작(추후 행동)으로 내보냅니다.
ARCHITECTURE
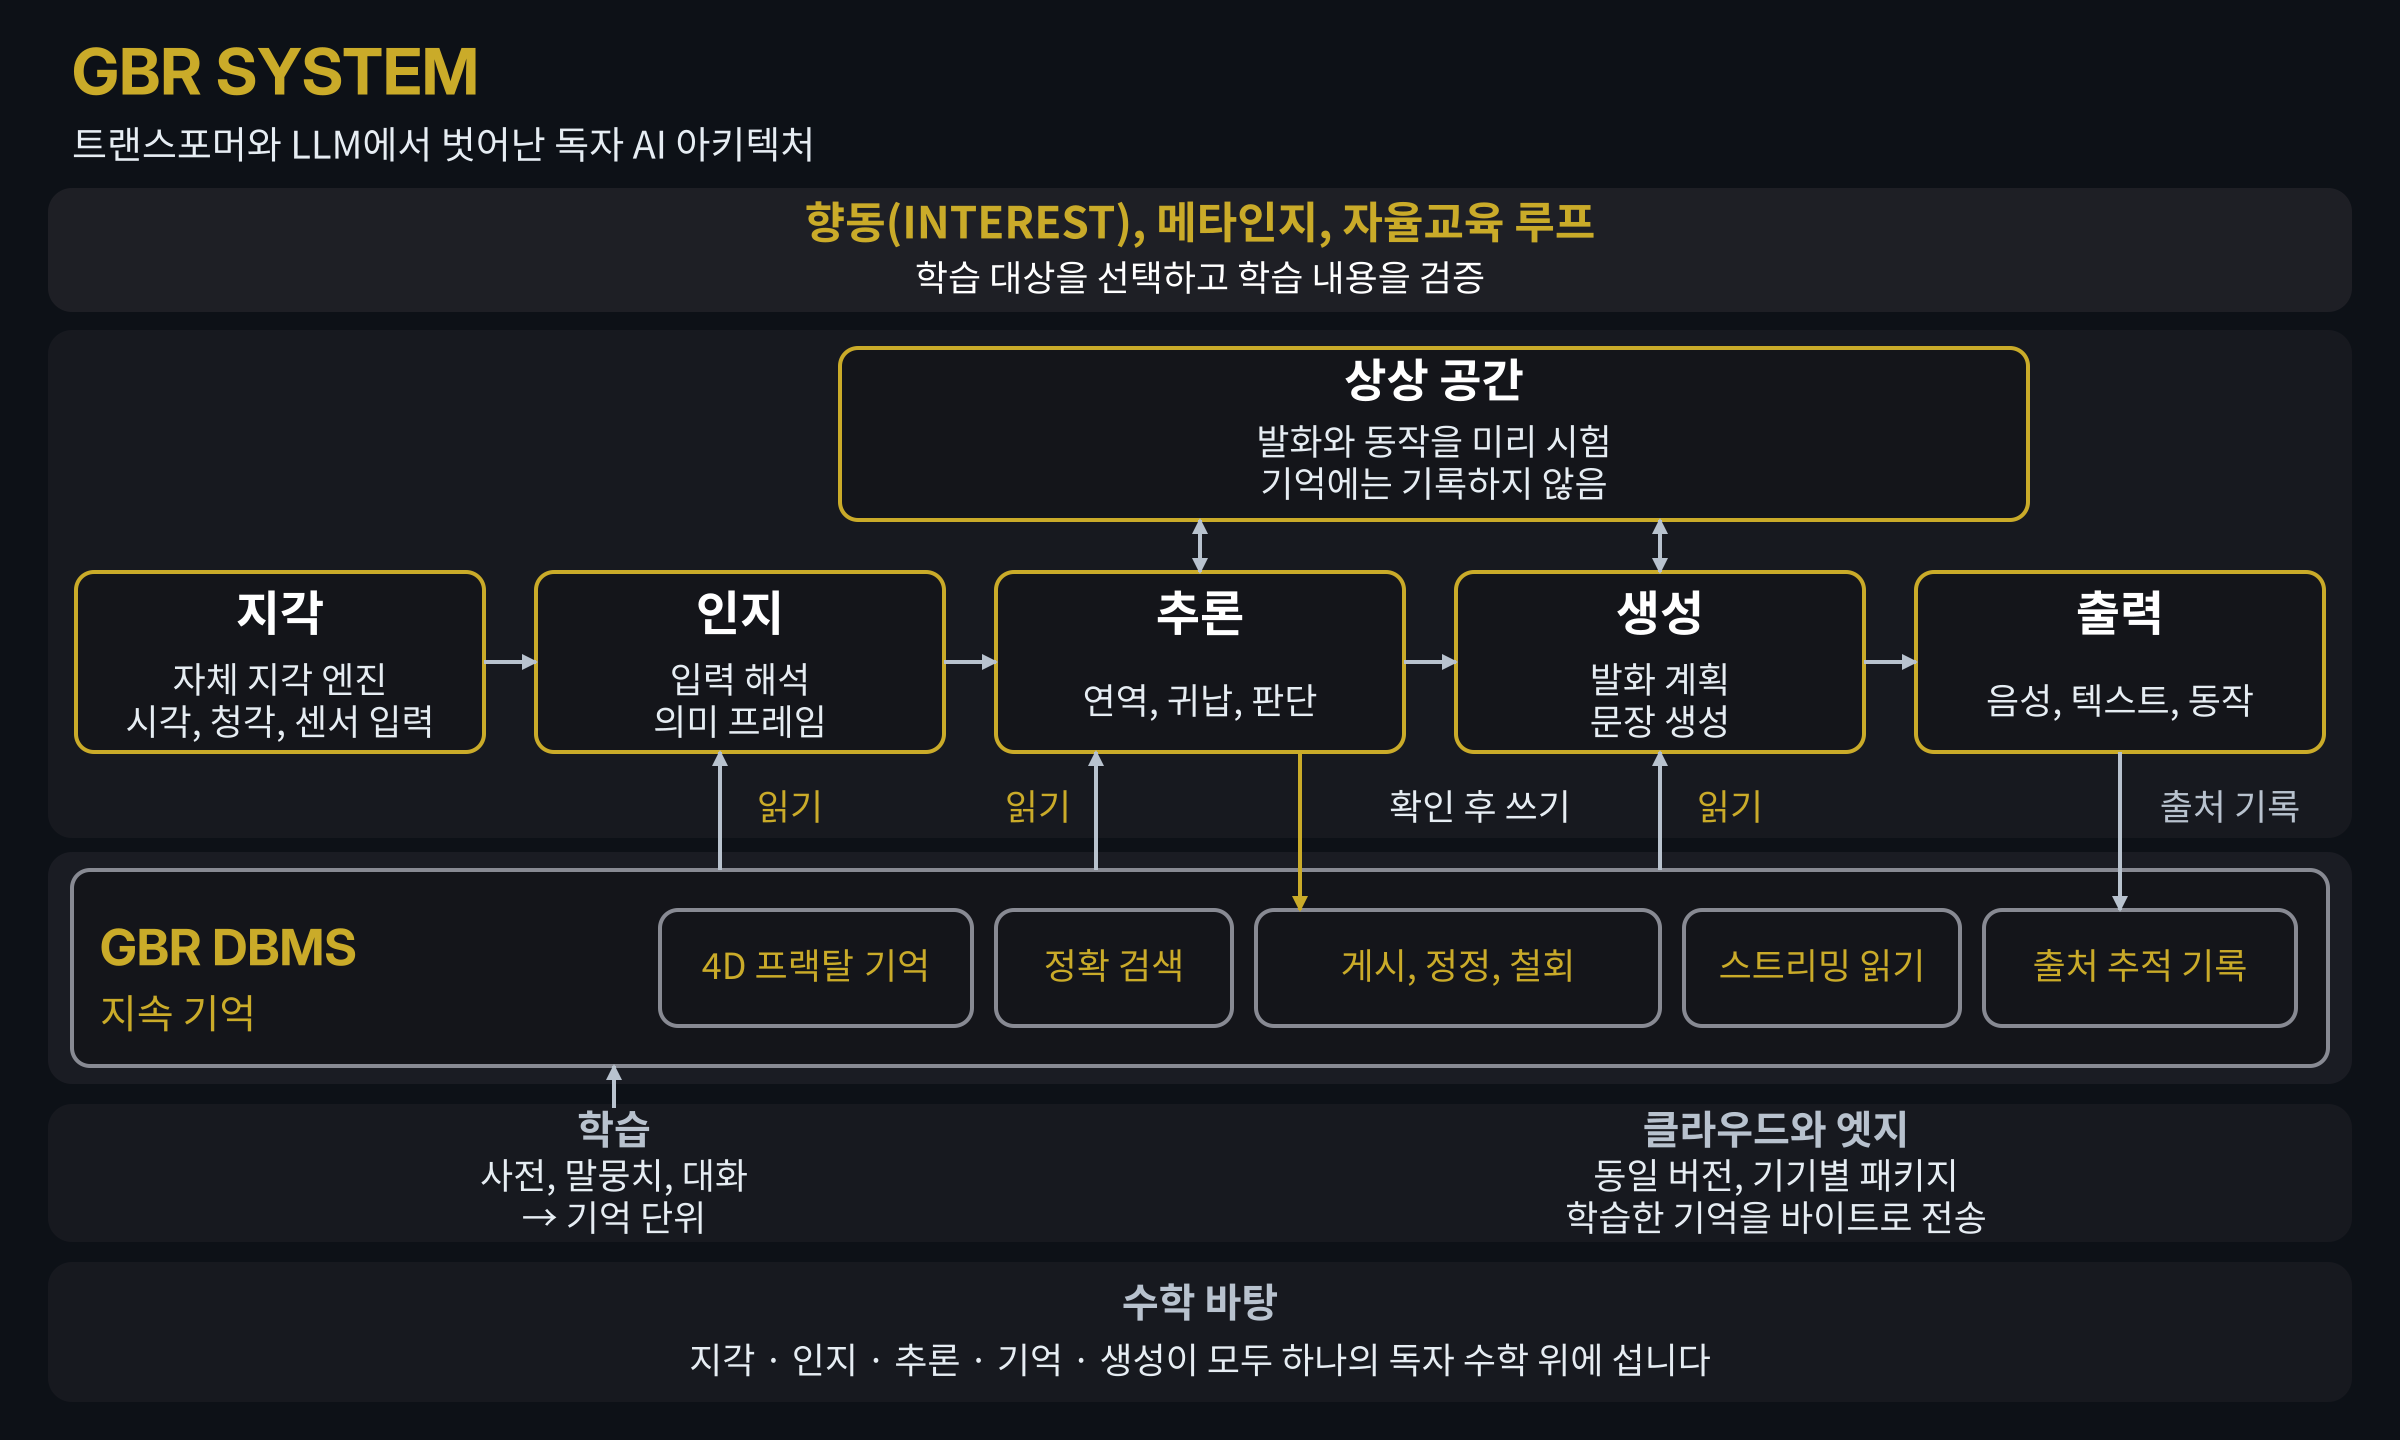
보고 듣는 지각, 알아듣는 인지, 연역과 귀납 등으로 따지는 추론, 말을 짓는 생성이 모두 같은 독자 수학 프레임워크를 바탕으로 하고, 4D 프랙탈 기억으로 이어 집니다. 트랜스포머, LLM 의존 없는 구조 입니다.
말하거나 움직이기 전에 상상 공간에서 먼저 시험합니다. 근거가 있으면 답하고, 갈리면 되묻고, 없으면 모른다고 말합니다.
GBR SYSTEM은 크게 두 부분으로 나뉩니다. 데이터를 저장하고 찾는 GBR DBMS 지각,인지,추론,생성,출력을 맡는 GBR AI 두 요소는 기억을 중심으로 연결됩니다. 엔진은 모두 직접 만들었습니다.
향동(INTEREST)이라 이름 붙인 자체 능동 기반과 메타인지, 자율교육 루프로 무엇을 배울지 스스로 고르고 배운 것을 따로 검증하고자 합니다.
| 가중치 기반 언어모델 | GBR | |
|---|---|---|
| 추론 | 다음 토큰을 이어 쓰며 추론 | 기억을 근거로 추론, 답하기 전에 상상 공간을 통한 시험 |
| 지식 저장 위치 | 학습된 가중치에 분산 | 버전 관리되는 기억 단위 |
| 스텝별 상태 | 대화와 함께 커지는 컨텍스트 윈도우(한도까지) | 고정 크기 대화 상태 + 필요할 때 찾아 읽는 기억 |
| 배운 결과의 반영 · 수정 | 재학습 · 파인튜닝 | 기억 단위의 게시 · 정정 · 철회 |
APPLICATIONS / WHAT COMES NEXT
통신이 끊긴 현장에서도 기기 혼자 보고 듣고 판단합니다. 값비싼 서버 없이도 기업과 개인이 필요한 지식을 직접 넣어 자신만의 AI를 가질 수 있습니다.
첫 적용 분야입니다. 저전력 소형 컴퓨터 한 대에서 외부 서버 없이 돕니다.
제품 지식을 직접 가르치고 바꾸며 장치에서 쓰는 플랫폼을 만들고 있습니다. 장치 등록 · 라이선스 · 업데이트 · 테스트 · 리포트를 잇는 GBR PHYSICAL AI STUDIO가 그 운영 도구입니다.
클라우드와 기기가 같은 GBR입니다. 배운 기억을 기기로 옮기고, 서로 기억을 나누도록 설계했습니다.
해외 기술에 기대지 않고 직접 만들고 통제하는 AI입니다. 자체 인지 엔진과 기억 저장소 위에서 기업과 개인이 자기 지식과 운영 환경을 직접 관리합니다.
A CLOSER LOOK
아닙니다. 자체 DBMS와 자체 AI를 함께 만들며 엮었습니다. 질문을 알아듣고 답을 짓는 일에 트랜스포머와 LLM을 쓰지 않고, 외부 LLM을 호출하지 않습니다.
데이터만 있으면 됩니다. 자체 임베딩을 거쳐 GBR AI를 통해 지식을 출처와 버전이 있는 기억 단위로 저장합니다. 새 지식을 게시하고 기존 내용을 정정하거나 철회하는 일은 데이터베이스 연산이라, 모델을 다시 학습하지 않아도 다음 답부터 반영됩니다. 모든 비정형 데이터를 소화하는 게 목표입니다.
같은 꼴이 기억 하나에서 묶음, 윗묶음까지 크기마다 되풀이되는 기억 구조입니다. 기억이 늘어도 필요한 부분만 찾아 읽을 수 있습니다.
기억은 기본적으로 손상되지 않는 한 지속됩니다. 그러나 스토리지 용량이 차오르면, 기억에도 시간이 필요해집니다. 기억을 얼마나 오래 간직할지 정할 수 있습니다. 변경은 따라가고, 꼭 기억해야 할 건 오래 간직합니다.
기억에서 찾아 상상 공간에서 조립하고 맞춰 봅니다. 이때 맞음을 세 겹으로 지킵니다. 근거가 있는 기억을 정확히 찾고, 추론은 증명서로 확인하며, 말하기 전에 상상 공간에서 시험합니다. 근거가 모자라면 모른다고 합니다.
'이산 갱신과 변분 연산에서 생기는 문제점'들이라고 말씀드릴 수 있습니다. AI가 정보를 갱신하고 계산하는 과정에서 생기는 고질적인 문제를 푸는 수학적 프레임워크입니다. 지각 · 인지 · 추론 · 기억 · 생성이 모두 그 위에 섭니다.
데이터셋 원본(Hugging Face)만 따로 내려받아 GitHub 저장소의 검사기를 돌리면, 1만 판의 답이 판마다 유일한 해임을 정답 확인 증명서로 누구나 다시 확인할 수 있습니다. 우리가 짓지 않은 바깥 검사기로도 1만 판을 모두 확인했습니다. 증명서가 보이는 것은 답의 정확성이며, 그 답을 GBR 추론 엔진이 냈다는 것은 회사 안의 실행 기록으로 확인했습니다.
현재 시연은 메모리 8 GB인 NVIDIA Jetson Orin Nano Super 한 대에서 네트워크를 차단한 채 했습니다. 지식이 기기 안의 기억에 있어 외부 서버 없이 답하고, 카메라와 모터 같은 장치도 자연어로 다룹니다. 더 작은 기기나 더 큰 기기에 적용이 예정되어 있습니다.
아직 배움이 부족합니다. 숫자와 한국어로 배운 지식으로 묻는 말에 답하고, 대화로 새 지식을 배우고 거둡니다. 배운 데이터가 아직 많지 않아 LLM만큼 유창하거나 놀라운 생성은 어렵지만, 확실히 작동합니다. (한국에서 만들어서 지금은 한국어와 숫자만 배웠습니다.)
소형 기기 · 로봇 제조사와, 머신러닝 · 데이터베이스 · 음성 · 로보틱스를 연구하시는 분들과 함께하고 싶습니다. 적용 과제와 장치 조건, 필요한 기억과 입출력을 함께 정하고 기술 검토와 PoC 범위를 협의합니다.
BUILD WITH ZIGU LABS
기술 문의, 연구, 제품 협력까지 주권이 필요한 지식과 지능에 관해 이야기 나눠요.